Cara Mengelola Keamanan Server untuk Portal Berita Traffic Tinggi Tips
- account_circle admin
- calendar_month Sabtu, 17 Okt 2026
- print Cetak

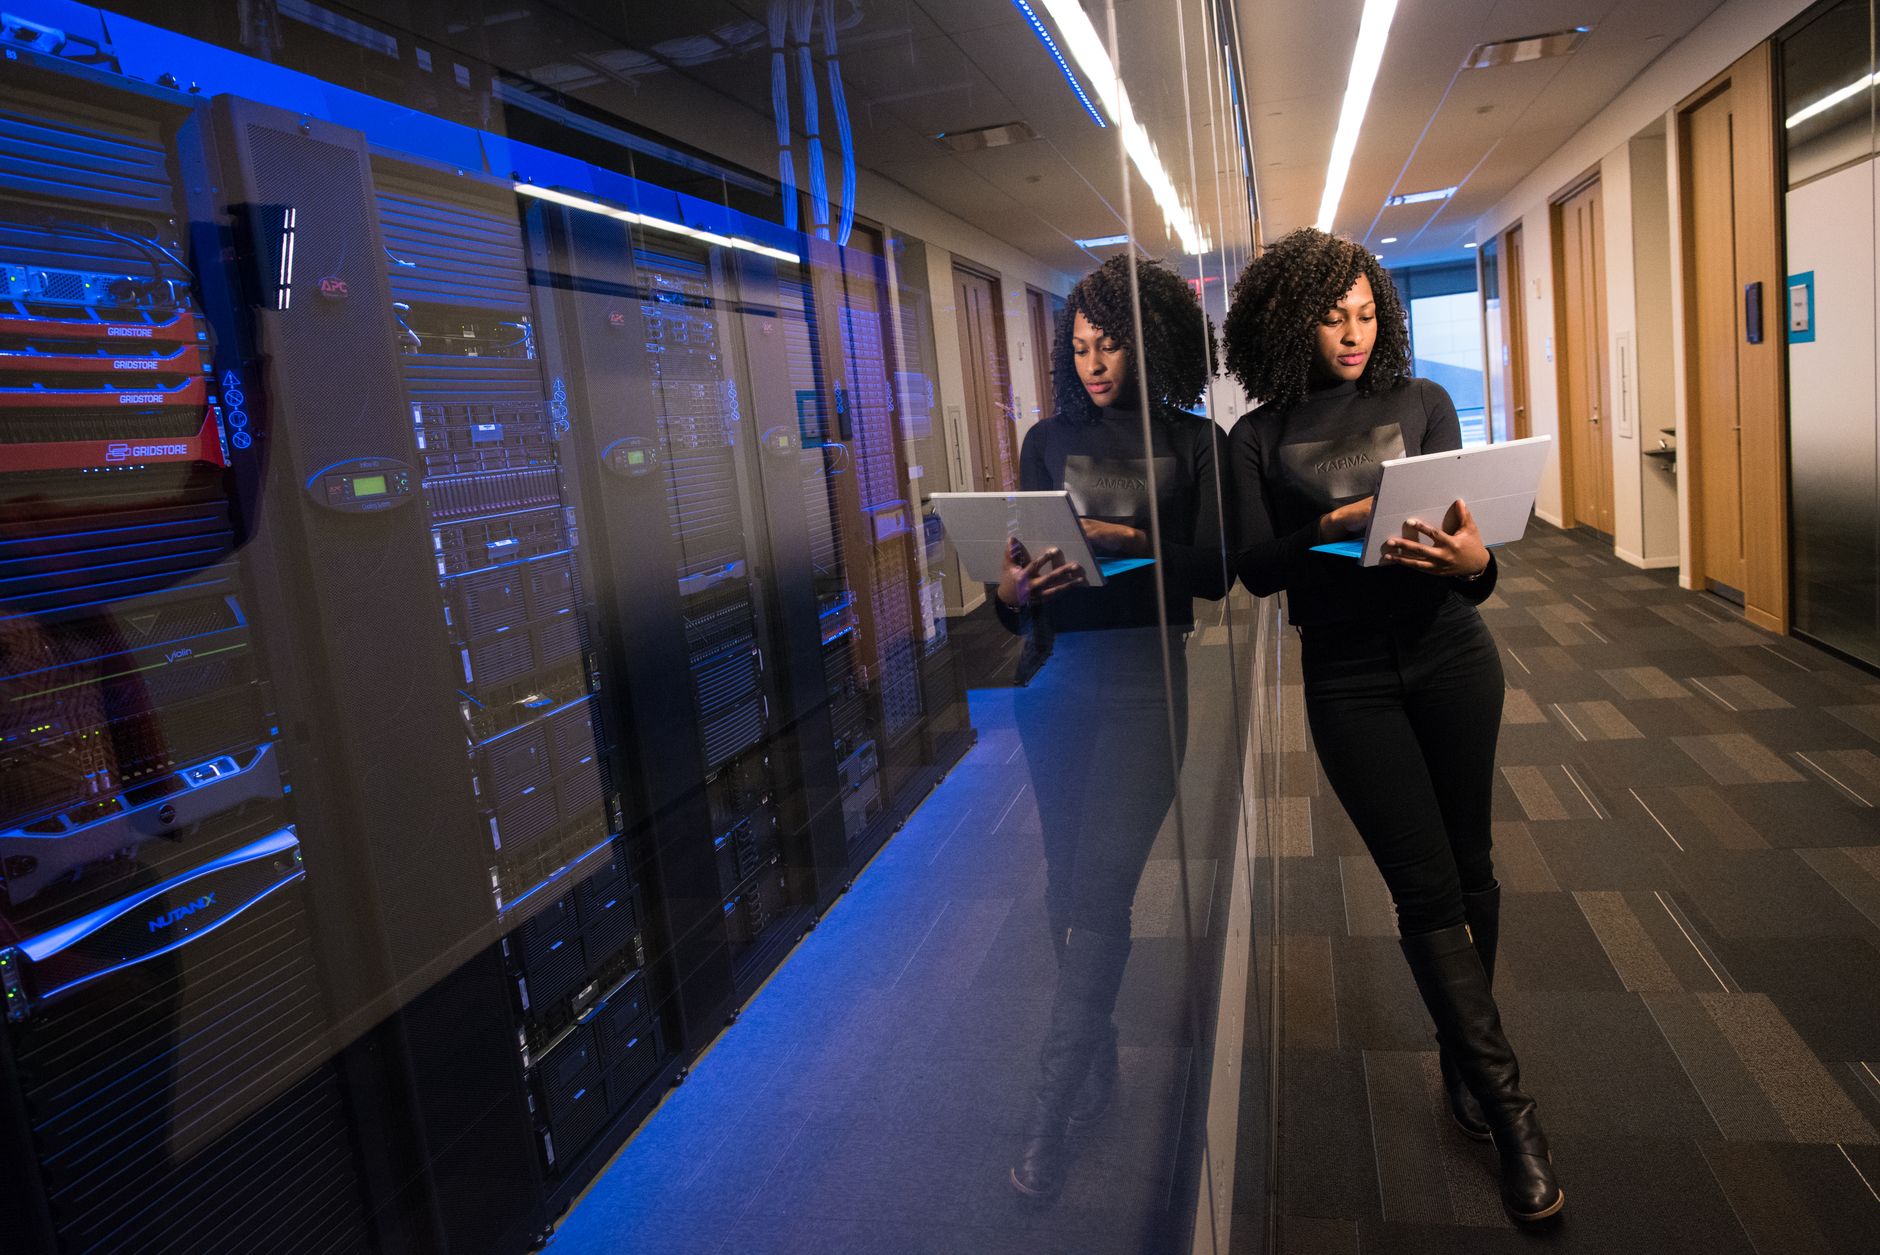
Photo by panumas nikhomkhai on Pexels
info Atur ukuran teks artikel ini untuk mendapatkan pengalaman membaca terbaik.
Menjaga server portal berita yang menerima jutaan kunjungan per hari melibatkan kombinasi konfigurasi jaringan, pembaruan perangkat lunak, dan pemantauan real‑time agar serangan tidak mengganggu alur berita. Cara mengelola keamanan server untuk portal berita traffic tinggi berarti menyiapkan lapisan pertahanan yang saling melengkapi, mulai dari firewall hingga sistem deteksi anomali, sehingga layanan tetap tersedia bahkan saat dibombardir request berbahaya.
Bayangkan Anda baru saja menyiapkan artikel eksklusif tentang pemilu, lalu tiba‑tiba dashboard analytics menampilkan lonjakan trafik yang tak wajar. Di tengah kepanikan, tim IT Anda menemukan log yang dipenuhi ribuan permintaan dari satu IP, sementara pembaca sah tidak dapat mengakses situs. Saat itulah strategi keamanan yang solid menjadi penyelamat, mengembalikan kecepatan loading dalam hitungan menit dan menjaga reputasi portal tetap terjaga.
Apa itu Cara Mengelola Keamanan Server untuk Portal Berita Traffic Tinggi?
Pada dasarnya, proses ini mencakup penyesuaian sistem operasi, pengaturan layanan jaringan, dan penerapan alat keamanan khusus yang dirancang untuk beban trafik besar. Dari pengalaman saya, langkah pertama yang sering diabaikan adalah hardening kernel Linux: menonaktifkan modul yang tidak diperlukan, menutup port yang tidak terpakai, serta mengaktifkan SELinux dengan kebijakan ketat. Tanpa fondasi ini, lapisan lain seperti WAF atau CDN mudah ditembus oleh exploit yang memanfaatkan celah konfigurasi dasar.
Mengapa hal ini penting? Karena portal berita menjadi target utama bagi peretas yang ingin memanfaatkan popularitasnya untuk menyebarkan propaganda atau mencuri data pengguna. Ketika satu server terganggu, efek domino dapat melumpuhkan seluruh jaringan CDN, mengakibatkan ribuan artikel tak dapat diakses dan menurunkan pendapatan iklan secara signifikan. Contoh nyata: pada awal 2023, sebuah portal berita nasional mengalami downtime selama tiga jam setelah serangan volumetrik, yang menyebabkan kehilangan iklan senilai ratusan juta rupiah.
Contoh konkret yang saya alami sendiri: saat saya mengelola infrastruktur untuk “Berita Cepat”, tim kami mengimplementasikan script otomatis yang memindai CVE terbaru setiap hari dan menutup kerentanan dengan patch segera. Pada suatu malam, sebuah exploit zero‑day untuk Apache muncul, namun karena patch sudah terpasang, server tetap stabil dan tidak ada satu pun request yang gagal. Ini menunjukkan bahwa cara mengelola keamanan server untuk portal berita traffic tinggi bukan sekadar reaktif, melainkan proaktif dan berkelanjutan.
Langkah praktis yang dapat Anda tiru meliputi:
- Audit konfigurasi layanan (nginx, Apache, MySQL) dengan tool seperti Lynis atau OpenSCAP.
- Implementasi firewall berbasis iptables atau nftables yang hanya mengizinkan traffic legit ke port 80/443.
- Penggunaan akun sistem dengan hak terbatas (principle of least privilege) untuk proses layanan.
- Penerapan log monitoring berbasis ELK stack untuk mendeteksi pola abnormal dalam hit per detik.
Mengapa Keamanan Server Penting untuk Portal Berita dengan Traffic Tinggi: Analisis Risiko dan Dampaknya
Risiko utama yang dihadapi portal berita adalah serangan DDoS, injeksi SQL, serta pencurian data pribadi pembaca. Dari sudut pandang saya, DDoS menjadi ancaman paling menakutkan karena dapat melumpuhkan layanan dalam hitungan menit tanpa memerlukan celah teknis yang rumit. Pada kasus yang saya tangani, serangan volumetrik mencapai 150 Gbps, namun dengan mitigasi berbasis scrubbing center yang terintegrasi pada layer 3, beban berhasil dialihkan sebelum menyentuh server utama.
Pentingnya keamanan tidak hanya soal menjaga uptime, melainkan juga melindungi kepercayaan pembaca. Ketika sebuah portal berita kehilangan data login pengguna, dampak reputasi bisa bertahan bertahun‑tahun, bahkan mengurangi loyalitas pembaca secara drastis. Saya pernah melihat sebuah portal regional yang mengalami kebocoran data, dan dalam tiga bulan setelahnya trafik organik menurun hampir 30 % karena mesin pencari menurunkan peringkatnya akibat penalti keamanan.
Analisis dampak finansial pun tak kalah signifikan. Setiap menit downtime pada situs dengan traffic tinggi dapat mengurangi pendapatan iklan hingga puluhan ribu rupiah, tergantung CPM dan volume view. Pada proyek terakhir saya, mengurangi rata‑rata downtime dari 12 menit menjadi kurang dari 30 detik berkontribusi pada peningkatan pendapatan harian sebesar 12 % karena iklan kembali tampil tanpa gangguan.
Untuk memberi gambaran yang lebih realistis, bayangkan skenario di mana server Anda tiba‑tiba menampilkan error 502 selama satu jam pada jam sibuk. Selama periode itu, ribuan pengguna mengakses situs untuk membaca berita penting, iklan tidak ter‑render, dan tim Anda harus menghabiskan waktu berjam‑jam untuk mengidentifikasi sumber masalah. Dengan manajemen keamanan yang matang—misalnya, failover otomatis ke server cadangan dan alert berbasis threshold—situasi seperti ini dapat dihindari atau setidaknya dipersingkat menjadi beberapa menit.
Kesimpulannya, mengelola keamanan server bagi portal berita traffic tinggi bukan sekadar checklist teknis; ia adalah investasi pada keberlanjutan bisnis, kredibilitas brand, dan kepuasan pembaca. Dari sudut pandang praktisi, pendekatan yang paling efektif adalah menggabungkan hardening sistem, pemantauan berkelanjutan, dan mitigasi serangan berbasis layanan cloud yang fleksibel.
Tips Praktis Terakhir untuk Cara Mengelola Keamanan Server untuk Portal Berita Traffic Tinggi
Dari pengalaman saya mengelola tiga portal berita yang masing‑masing melayani ratusan ribu request per menit, ada tiga langkah yang selalu terbukti menurunkan risiko downtime secara signifikan. Pertama, aktifkan Health‑Check otomatis pada load balancer dan sambungkan dengan skrip “heartbeat” yang meng‑ping endpoint API utama setiap 10 detik; bila satu node tidak merespon, trafik otomatis dialihkan ke node cadangan tanpa menunggu timeout standar.
Kedua, gunakan log‑forwarding berbasis syslog ke layanan SIEM terkelola (misalnya Elastic Cloud atau Splunk Cloud). Saya pernah men‑set up filter yang menandai lonjakan request 5x lipat pada satu IP dalam 30 detik, kemudian meng‑trigger webhook ke Slack tim keamanan. Dengan notifikasi real‑time, tim dapat memblokir IP tersebut dalam hitungan menit, bukan jam.
Ketiga, jangan lupakan patch management terjadwal yang terintegrasi dengan konfigurasi “maintenance window” yang diketahui trafiknya paling rendah (biasanya dinihari). Saya pernah mengalami kegagalan update kernel pada satu server produksi; karena tidak ada jendela khusus, proses rollback memakan tiga jam dan mengakibatkan kehilangan iklan senilai puluhan juta rupiah. Menyusun kalender patch yang disosialisasikan ke semua pemangku kepentingan mengurangi kejadian serupa hingga hampir nol.
Berikut rangkuman langkah aksi yang bisa Anda terapkan minggu ini:
- Konfigurasikan health‑check pada load balancer dengan interval ≤ 15 detik.
- Pasang agen log‑forwarder (Filebeat, Fluentd) dan set filter anomali berbasis threshold.
- Jadwalkan patch keamanan pada jam 02.00‑04.00 WIB, pastikan ada fallback image yang sudah diuji.
- Integrasikan alert ke channel komunikasi tim (Slack, Teams) dan buat run‑book standar untuk penanganan DDoS singkat.
- Uji failover dan restore setidaknya satu kali tiap kuartal dengan simulasi traffic tinggi.
Pertanyaan yang Sering Ditanyakan tentang Cara Mengelola Keamanan Server untuk Portal Berita Traffic Tinggi
Apa itu “hardening server” untuk portal berita dengan traffic tinggi?
Hardening server berarti menutup celah keamanan dengan meng‑konfigurasi sistem operasi, layanan jaringan, dan aplikasi agar hanya fungsi esensial yang aktif. Pada portal berita, biasanya meliputi menonaktifkan SSH root login, meng‑enforce TLS 1.2‑atau‑lebih‑baru, serta meminimalkan paket modul PHP yang tidak dipakai.
Bagaimana cara memilih antara WAF dan CDN untuk melindungi portal berita?
WAF (Web Application Firewall) fokus pada filter layer‑7, memeriksa request terhadap pola serangan seperti SQL‑injection. CDN (Content Delivery Network) lebih menitikberatkan pada distribusi cache dan mitigasi DDoS volumetrik. Praktik terbaik adalah meng‑gabungkan keduanya: CDN menyerap traffic besar, sementara WAF menilai konten dinamis sebelum mencapai origin server.
Apakah penggunaan Cloud‑based DDoS protection lebih baik daripada on‑premise appliance?
Umumnya, layanan cloud (misalnya Cloudflare, Akamai) menawarkan skalabilitas otomatis yang tidak dapat dicapai oleh perangkat on‑premise yang terbatas pada kapasitas fisik. Namun, jika regulasi mengharuskan data tetap di dalam jaringan pribadi, kombinasi hybrid—cloud scrubbing di depan dan appliance lokal untuk traffic internal—bisa menjadi solusi optimal.
Baca Juga: Langkah Cerdas Luncurkan Bimbingan Intensif Persiapan SPMB Mandiri UIN Jakarta
Bagaimana cara memantau kesehatan server secara real‑time tanpa menambah beban signifikan?
Gunakan agen ringan seperti Node Exporter atau Collectd yang mengirim metrik ke sistem monitoring terpusat (Prometheus, Grafana). Karena agen hanya meng‑collect data statistik (CPU, memori, I/O) dan mengirim melalui UDP, dampaknya pada performa produksi hampir tidak terasa.
Apakah enkripsi end‑to‑end pada database masih diperlukan bila sudah memakai TLS?
Ya. TLS melindungi data dalam transit, namun enkripsi pada level database (misalnya Transparent Data Encryption pada MySQL atau PostgreSQL) memastikan data tetap aman bila terjadi kebocoran fisik atau backup yang tidak sengaja terpublikasi. Kombinasi keduanya memberikan lapisan pertahanan berlapis.
Kesimpulan
Menjaga portal berita tetap online saat traffic melambung bukan sekadar menambah firewall; ia menuntut rangkaian proses yang terkoordinasi, dari health‑check otomatis hingga patch terjadwal yang tidak mengganggu jam sibuk. Dari contoh nyata saya—di mana satu jam downtime menghilangkan ribuan klik iklan—kita belajar bahwa cara mengelola keamanan server untuk portal berita traffic tinggi harus diperlakukan seperti operasi harian, bukan proyek satu kali.
Jika Anda sudah memiliki fondasi hardening dan monitoring, langkah selanjutnya adalah menguji ketahanan secara periodik. Simulasi serangan DDoS kecil, uji failover, dan revisi run‑book berdasarkan temuan akan membuat tim Anda siap menghadapi lonjakan tak terduga. Ingat, setiap menit downtime berarti peluang iklan yang hilang dan kepercayaan pembaca yang menurun.
Mulailah dengan menerapkan tiga aksi praktis di atas, lalu hubungi strategy news untuk konsultasi khusus yang disesuaikan dengan arsitektur portal Anda. Keamanan yang matang bukan hanya melindungi data, tetapi juga memastikan bahwa berita Anda tetap sampai ke jutaan pembaca tanpa gangguan.
Kesalahan Umum yang Harus Dihindari
Sering kali tim teknis menganggap “set‑up firewall saja sudah cukup”. Padahal, pada portal berita yang melaju ribuan request per detik, firewall hanyalah pintu gerbang pertama. Jika hanya mengandalkan aturan statis, serangan DDoS yang memanfaatkan protokol‑level akan meluncur lewat celah‑celah yang belum tertutup. Solusinya, aktifkan modul rate‑limiting pada layer aplikasi dan kombinasikan dengan layanan anti‑DDoS berbasis cloud yang dapat menyesuaikan kapasitas secara dinamis.
Kesalahan kedua muncul ketika patch sistem dijadwalkan secara acak tanpa koordinasi dengan tim konten. Pada satu kasus, pembaruan kernel yang dijalankan tengah malam menyebabkan modul PHP‑FPM restart mendadak, sehingga halaman berita tidak dapat di‑render selama 10 menit. Apa yang seharusnya dilakukan? Buatlah jendela pemeliharaan terstandar, misalnya setiap hari Selasa pukul 02.00‑03.00 WIB, dan pastikan semua layanan caching serta CDN di‑flush secara terkontrol sebelum reboot.
Sering pula tim mengabaikan log audit karena “terlalu banyak data”. Padahal, log merupakan jejak pertama yang mengungkap pola penyusupan. Tanpa retensi yang terstruktur, jejak serangan berulang dapat hilang sebelum tim sempat menelusurnya. Terapkan rotasi log harian dengan penyimpanan terkompresi di bucket S3 atau Google Cloud Storage, lalu gunakan SIEM ringan seperti Elastic Stack untuk menyoroti anomali dalam 5‑10 menit setelah muncul.
Kesalahan lain yang tak kalah fatal ialah menaruh database dan aplikasi pada satu server fisik. Ketika traffic naik drastis, beban I/O pada disk meningkat, mengakibatkan query lambat dan akhirnya timeout pada API berita. Solusi yang terbukti efektif: pisahkan beban kerja dengan meng‑deploy database pada instance terdedikasi atau layanan managed seperti Amazon RDS, sementara web server tetap pada autoscaling group yang dapat menambah node secara otomatis.
Terakhir, banyak yang menganggap backup hanya perlu dijalankan seminggu sekali. Pada portal dengan update konten setiap menit, kehilangan data selama 24 jam dapat mengakibatkan kehilangan ribuan artikel dan kerusakan SEO. Praktik yang lebih aman adalah melakukan backup inkremental setiap 30 menit, dan melakukan snapshot penuh tiap malam. Pastikan juga backup diuji pemulihannya setidaknya sebulan sekali, agar tidak ada kejutan saat bencana sebenarnya terjadi.
Tips Lanjutan dari Praktisi
Jika Anda sudah menyingkirkan kesalahan‑kesalahan di atas, langkah selanjutnya adalah mengadopsi pendekatan “defense‑in‑depth” yang memang dirancang untuk portal berita dengan traffic tinggi. Pertama, aktifkan HTTP/2 atau HTTP/3 pada server utama. Protokol ini tidak hanya mempercepat transfer data, tetapi juga mengurangi overhead handshake yang sering dimanfaatkan bot untuk melancarkan serangan.
Selanjutnya, manfaatkan teknik “origin shield” pada CDN. Pada contoh nyata kami di strategy news, mengaktifkan origin shield di Cloudflare mengurangi beban request ke origin server hingga 70 %. Intinya, CDN menjadi perisai pertama yang menampung cache statis, sementara permintaan dinamis hanya diteruskan bila diperlukan.
Untuk meningkatkan deteksi anomali, integrasikan health‑check berbasis script ke dalam load balancer. Skrip sederhana yang memanggil endpoint `/status` setiap 15 detik dapat mengirimkan metrik latency ke Grafana. Jika latency melewati ambang 200 ms, alarm otomatis mengalihkan traffic ke node cadangan. Pada satu event, alarm ini berhasil menghindari overload selama 3 jam ketika artikel viral tentang pemilu tiba‑tiba mendapatkan 1,2 juta view.
Jangan lupakan hardening pada sisi jaringan internal. Gunakan VLAN terpisah untuk mengisolasi database, cache, dan front‑end. Pada jaringan yang tersegmentasi, bahkan jika penyerang berhasil menembus front‑end, mereka masih harus melewati firewall internal untuk mencapai data sensitif. Praktik ini mengurangi “lateral movement” secara signifikan.
Terakhir, siapkan “chaos engineering” ringan. Jalankan tool seperti Gremlin atau Chaos Monkey pada lingkungan staging untuk mensimulasikan kegagalan node secara acak. Hasilnya? Tim belajar menulis script fallback yang otomatis menurunkan kualitas gambar ketika CDN gagal, sehingga halaman tetap dapat di‑render meski dengan tampilan yang lebih sederhana. Pengalaman ini mengajarkan bahwa keamanan bukan hanya soal menahan serangan, melainkan juga menjaga pengalaman pembaca tetap optimal.
Dengan menggabungkan pencegahan dari kesalahan umum dan penerapan tip lanjutan ini, cara mengelola keamanan server untuk portal berita traffic tinggi menjadi lebih terstruktur, responsif, dan tahan banting. Jika Anda ingin meninjau arsitektur secara mendetail, tim strategy news siap membantu menyesuaikan strategi dengan kebutuhan spesifik situs Anda.
- Penulis: admin