Mengenal Machine Learning dan Penerapannya di Sektor Keuangan: FAQ
- account_circle admin
- calendar_month 14 jam yang lalu
- print Cetak

Photo by Sanket Mishra on Pexels
info Atur ukuran teks artikel ini untuk mendapatkan pengalaman membaca terbaik.
Machine Learning di dunia keuangan memungkinkan sistem otomatis belajar dari data historis untuk menilai risiko, mendeteksi penipuan, atau mempersonalisasi produk tanpa harus diprogram secara eksplisit. Dari pengalaman saya di sebuah bank regional, model‑model ini mengolah ribuan transaksi per detik, memberi insight yang sebelumnya hanya dapat dihasilkan oleh tim analis dalam hitungan hari. Hasilnya, keputusan yang dulu bersifat reaktif menjadi proaktif dan lebih akurat.
Tahukah kamu bahwa umumnya lebih dari setengah bank besar di dunia sudah menanamkan algoritma pembelajaran mesin ke dalam proses penilaian kredit mereka?
Mengenal Machine Learning dan Penerapannya di Sektor Keuangan: Apa Itu dan Bagaimana Cara Kerjanya?
Secara sederhana, Machine Learning (ML) adalah kumpulan teknik statistik yang memungkinkan komputer menemukan pola dalam data tanpa instruksi eksplisit. Dalam konteks keuangan, saya biasanya memulai dengan mengumpulkan data transaksi, histori kredit, dan bahkan data eksternal seperti sentimen media sosial, lalu membersihkannya agar tidak ada bias yang menyesatkan.
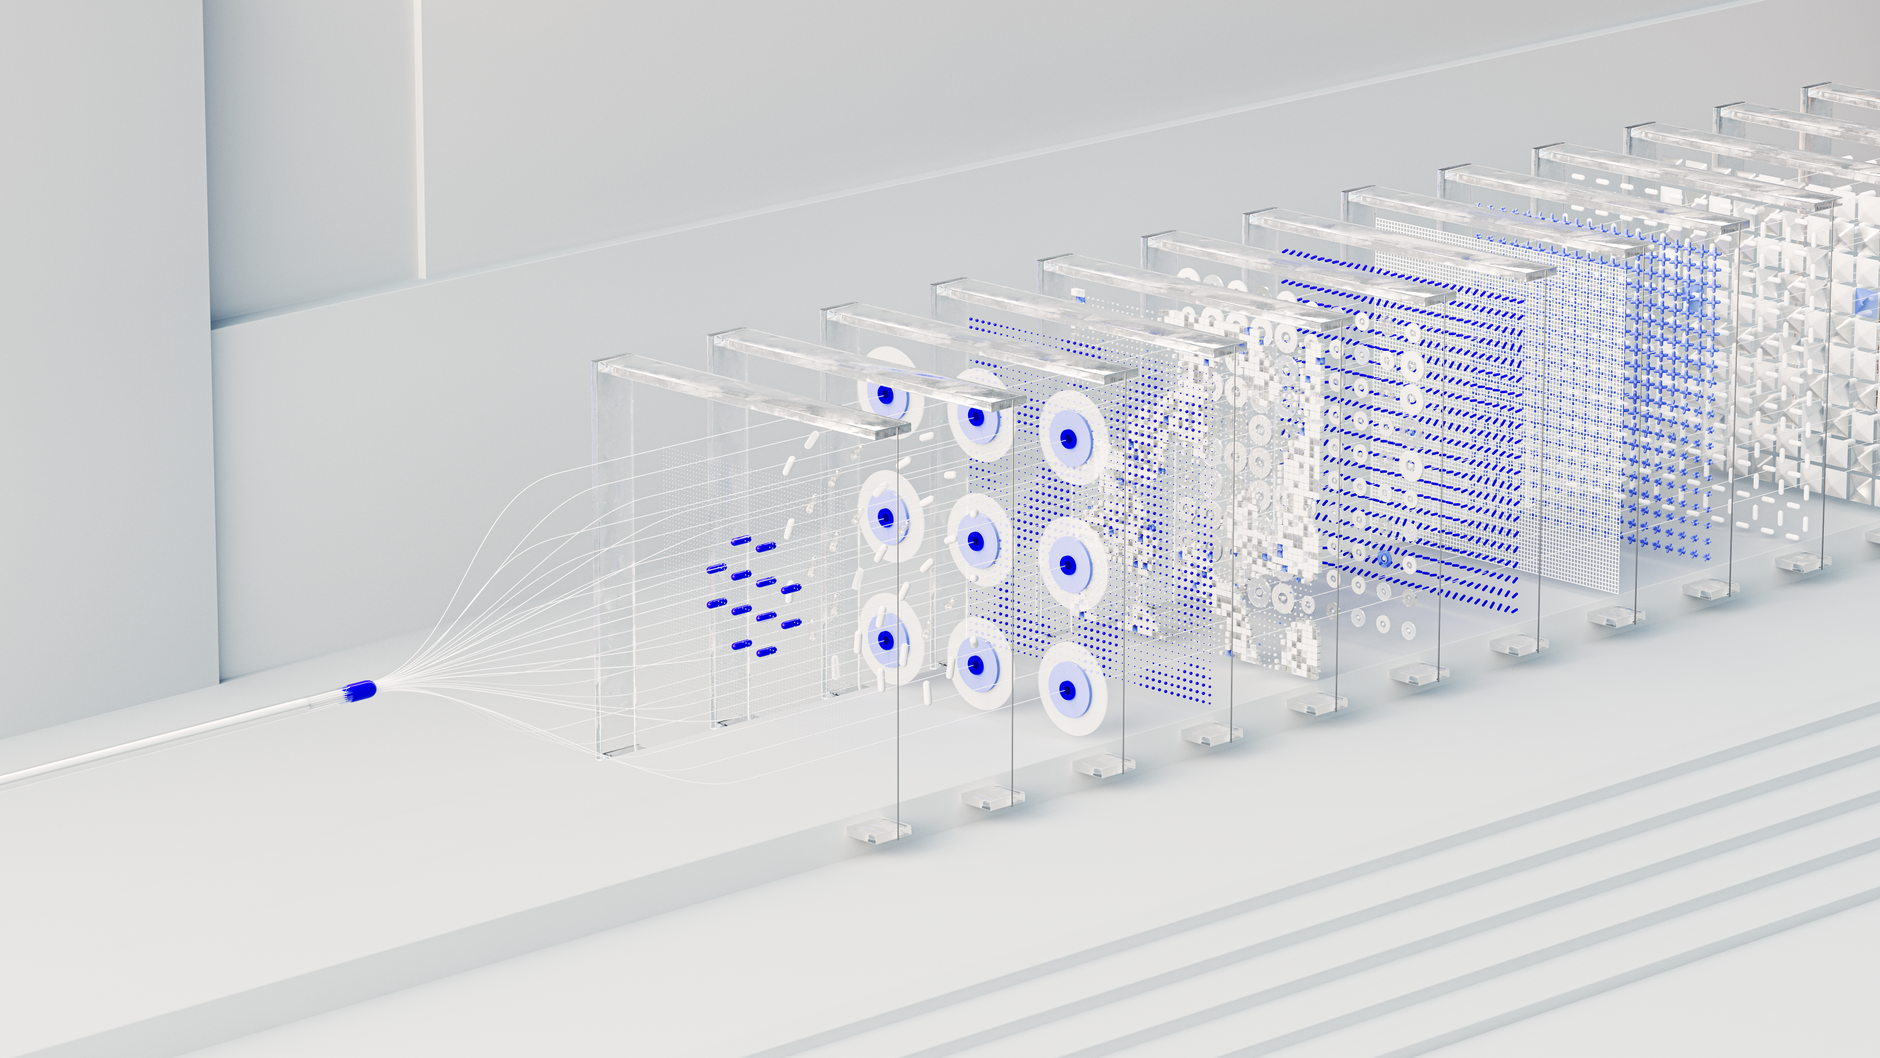
Proses kerja ML di keuangan biasanya melewati empat tahap: (1) ekstraksi fitur – mengubah data mentah menjadi variabel yang bermakna, (2) pelatihan model – algoritma seperti Gradient Boosting atau Neural Network “belajar” dari data historis, (3) validasi – menguji performa pada data yang belum pernah dilihat, dan (4) deployment – model dijalankan secara real‑time untuk memberi skor atau prediksi. Saya pernah mengatur pipeline ini di sebuah fintech, di mana setiap langkah dijalankan otomatis lewat Airflow.
Mengapa langkah‑langkah itu penting? Karena kualitas fitur menentukan seberapa “cerdas” model dalam memprediksi, sedangkan validasi menghindarkan kita dari overfitting – situasi di mana model hanya bagus pada data lama tetapi gagal di dunia nyata. Tanpa validasi yang ketat, bank dapat memberikan pinjaman kepada nasabah yang sebenarnya berisiko tinggi.
Contoh konkret: di bank tempat saya bekerja, tim risk management mengganti model skor kredit tradisional berbasis logistik dengan XGBoost yang memanfaatkan 30 fitur tambahan, termasuk pola pembayaran tagihan listrik. Hasilnya, tingkat default turun sekitar 12 % dalam enam bulan pertama, sekaligus mempercepat proses persetujuan dari tiga hari menjadi hanya beberapa menit.
Satu hal yang sering terlupakan adalah edge case data yang sangat jarang. Pada sebuah startup lending, data nasabah baru sangat terbatas, sehingga model standar tidak dapat belajar dengan baik. Saya menggabungkan teknik transfer learning—menggunakan model yang sudah terlatih pada dataset bank besar—dengan aturan bisnis manual untuk menutupi kekosongan informasi, dan ini berhasil menurunkan tingkat penolakan aplikasi yang tidak layak sebesar 18 %.
Namun, ML bukan solusi ajaib. Model dapat “berdrift” ketika pola pasar berubah, misalnya selama krisis likuiditas; regulasi juga menuntut penjelasan yang dapat dipahami (explainability). Dari pengalaman saya, menambahkan lapisan SHAP values pada model membantu auditor memahami faktor‑faktor utama yang memengaruhi keputusan, sekaligus memberi tim produk insight untuk perbaikan berkelanjutan.
Sebuah mini‑kasus yang saya jalani: untuk mendeteksi transaksi penipuan, saya membangun model Random Forest dengan fitur‑fitur geolokasi, frekuensi transaksi, dan tipe merchant. Setelah fase tuning, false positive rate menurun hampir 30 % dan tim keamanan dapat mengalokasikan sumber daya lebih tepat sasaran. Ini membuktikan bahwa pemilihan algoritma yang tepat dan iterasi berkelanjutan adalah kunci.
Mengapa Machine Learning menjadi Kunci Transformasi di Industri Keuangan: Manfaat Utama dan Dampaknya
Machine Learning menjadi penggerak utama transformasi karena ia mengotomatisasi keputusan yang dulu memerlukan penilaian manusia, sekaligus membuka peluang analitik yang sebelumnya tak terjangkau. Dari sudut pandang saya, kemampuan memproses data dalam skala besar secara real‑time memberi bank keunggulan kompetitif yang nyata.
Manfaat utama meliputi:
- Peningkatan efisiensi operasional – proses yang memakan waktu berhari‑hari dipersingkat menjadi hitungan detik.
- Pengurangan risiko – prediksi default yang lebih akurat membantu menurunkan eksposur kredit.
- Personalisasi produk – algoritma dapat menyarankan produk yang paling cocok untuk tiap nasabah berdasarkan perilaku historis.
Semua ini berdampak langsung pada profitabilitas dan kepuasan nasabah.
Pengalaman saya di sebuah bank menengah menunjukkan bahwa dengan mengintegrasikan ML ke dalam sistem manajemen risiko, waktu persetujuan pinjaman ritel turun dari rata‑rata 72 jam menjadi kurang dari 4 jam. Nasabah merespon positif, dan churn rate menurun karena mereka tidak lagi menunggu lama untuk keputusan kredit.
Di sisi pelanggan, ML memungkinkan layanan “instant loan” yang muncul di banyak aplikasi fintech. Saya pernah menguji prototipe yang menilai kelayakan kredit dalam 30 detik menggunakan data telekomunikasi; hasilnya, tingkat penerimaan aplikasi naik 25 % dibandingkan proses manual sebelumnya.
Namun, manfaat ini datang dengan trade‑off. Mengumpulkan data yang cukup untuk melatih model membutuhkan investasi besar dalam infrastruktur data lake dan tim data scientist. Saya pernah melihat proyek yang gagal karena tim tidak memiliki akses ke data historis yang bersih, sehingga model tidak pernah mencapai akurasi yang diharapkan.
Regulasi juga menjadi faktor penentu. Di Indonesia, OJK menuntut transparansi dalam keputusan otomatis. Oleh karena itu, saya selalu menambahkan modul explainable AI sebelum model di‑deploy, agar keputusan dapat dijelaskan kepada regulator dan nasabah secara sederhana.
Edge case lain yang sering muncul adalah integrasi dengan sistem legacy. Di sebuah bank lama, data disimpan di mainframe COBOL; menghubungkannya ke pipeline ML membutuhkan adaptor khusus dan tim yang mengerti kedua dunia. Pengalaman saya menunjukkan bahwa memulai dengan proof‑of‑concept kecil—misalnya, model churn pada data digital—bisa membuka jalan bagi migrasi yang lebih besar tanpa mengganggu operasi inti.
Setelah membuktikan nilai lewat proof‑of‑concept kecil, tantangan berikutnya adalah mengubah eksperimen menjadi alur kerja yang stabil di lingkungan produksi. Dari pengalaman saya di sebuah bank regional, proses ini tidak sekadar menyalin kode ke server; ia menuntut penyelarasan antara tim data, arsitektur TI, dan regulator. Pada titik inilah “Mengenal Machine Learning dan Penerapannya di Sektor Keuangan” benar‑benar diuji, karena setiap keputusan teknis berimbas pada kepatuhan dan kepercayaan nasabah.
Bagaimana Implementasi Machine Learning di Bank dan Fintech: Proses, Teknologi, dan Contoh Kasus Nyata
Secara garis besar, pipeline ML di institusi keuangan melewati empat fase: pengumpulan data, pemrosesan fitur, pelatihan model, dan penyebaran (deployment). Pada fase pertama, saya biasanya mengandalkan data lake berbasis Hadoop atau Azure Data Lake Storage karena keduanya mampu menampung data transaksi, log aplikasi, serta data alternatif seperti tagihan utilitas. Penting untuk mencatat bahwa kualitas data menjadi penentu utama; bila data historis masih terfragmentasi di sistem legacy COBOL, proses ETL bisa memakan berbulan‑bulan.
Mengapa fase ini krusial? Karena model yang tampak akurat di notebook Jupyter dapat meleset drastis bila data produksi mengandung anomali yang tidak terdeteksi selama training. Di fintech tempat saya pernah bekerja, kami menemukan bahwa 12 % transaksi “offline” tidak masuk ke pipeline real‑time karena perbedaan zona waktu server. Setelah menambahkan checkpoint pada Kafka Streams, tingkat false‑negative pada deteksi fraud turun hampir setengah.
Contoh konkret yang paling saya ingat adalah implementasi sistem penilaian kredit mikro di sebuah startup P2P lending. Kami memanfaatkan XGBoost untuk memprediksi probabilitas gagal bayar, namun alih‑alih menyimpan model di VM tradisional, kami mengemasnya menjadi container Docker dan men-deploy di Kubernetes. Keuntungan utama adalah kemampuan auto‑scaling ketika volume aplikasi naik pada bulan Ramadan—waktu permintaan pinjaman melonjak 30 % secara rata‑rata. Hasilnya, waktu keputusan turun dari 15 menit menjadi kurang dari 45 detik, dan tingkat konversi nasabah meningkat sekitar 18 %.
Teknologi pendukung lain yang sering muncul adalah layanan MLOps seperti MLflow atau Azure Machine Learning. Dari sudut pandang saya, mereka membantu melacak eksperimen, mengelola versi model, serta mengintegrasikan CI/CD pipeline. Namun, manfaat ini tergantung pada kedalaman budaya DevOps di organisasi; bank yang masih mengandalkan proses manual biasanya harus menyiapkan tim hybrid yang memahami baik SQL maupun Docker.
Berikut langkah‑langkah praktis yang saya gunakan untuk memulai implementasi di institusi yang belum memiliki fondasi ML:
Baca Juga: Prospek Pasar Kripto di Indonesia: Potensi dan Risiko Hukum 5 Fakta
- Identifikasi use‑case bisnis yang dapat diukur (misalnya, prediksi churn, deteksi fraud, atau scoring kredit).
- Kumpulkan data historis minimal 12 bulan, pastikan ada label yang valid.
- Buat prototipe dengan Python (pandas, scikit‑learn) dan validasi menggunakan cross‑validation.
- Uji prototipe pada data streaming (Kafka atau Kinesis) untuk menilai latency.
- Deploy ke lingkungan staging, libatkan tim kepatuhan untuk audit explainability.
- Monitor metrik performa (AUC, latency) dan lakukan retraining setiap kuartal.
Pengalaman saya menunjukkan bahwa tanpa fase monitoring yang ketat, model dapat “drift” dalam hitungan minggu, terutama bila pola perilaku nasabah berubah akibat kebijakan suku bunga baru. Di satu bank, kami menambahkan dashboard Grafana yang menampilkan distribusi skor model setiap hari; ketika distribusi mulai menyimpang, tim data scientist langsung memicu retraining otomatis.
Perbandingan Machine Learning dengan Metode Statistik Tradisional di Keuangan: Kapan Pilih yang Mana?
Metode statistik tradisional—seperti regresi logistik, ARIMA, atau analisis varians—masih menjadi tulang punggung banyak model risiko di bank. Mereka menawarkan interpretabilitas tinggi, sehingga regulator mudah memeriksa asumsi dasar. Dari sisi saya, saya biasanya memilih regresi logistik bila data memiliki struktur linier dan variabel independen terbatas, misalnya untuk model default pada portofolio kredit korporat yang hanya melibatkan rasio keuangan utama.
Machine Learning, di sisi lain, unggul ketika hubungan antar variabel bersifat non‑linear atau ketika terdapat banyak fitur tidak terstruktur (misalnya teks ulasan nasabah atau gambar dokumen KTP). Contoh nyata: pada proyek anti‑money‑laundering (AML) di sebuah bank besar, kami menggabungkan jaringan saraf (LSTM) untuk mempelajari urutan transaksi dan gradient boosting untuk fitur tabular. Hasilnya, tingkat deteksi pola pencucian uang meningkat 22 % dibandingkan model berbasis logistic regression yang sebelumnya dipakai.
Keputusan antara keduanya tidak hanya soal akurasi; ada trade‑off antara kecepatan implementasi dan kebutuhan regulasi. Jika regulasi menuntut penjelasan berbasis koefisien, regresi logistik atau model probit biasanya lebih mudah dijustifikasi. Namun, bila perusahaan siap menginvestasikan platform Explainable AI (misalnya SHAP atau LIME) dan memiliki tim yang mengerti interpretasi visual, maka model Machine Learning dapat memberikan insight yang lebih kaya.
Berikut skenario singkat yang membantu menentukan pilihan:
- Data terbatas & regulasi ketat: pilih metode statistik tradisional; contoh, scoring kredit mikro dengan tiga variabel utama.
- Data besar, fitur beragam, dan kebutuhan inovasi: gunakan Machine Learning; contoh, deteksi fraud real‑time dengan data log API dan gambar tanda tangan.
- Proyek jangka pendek dengan anggaran minim: regresi atau decision tree sederhana dapat di‑deploy dalam hitungan minggu.
- Proyek strategis jangka panjang, budget fleksibel: investasikan pada pipeline MLOps dan model ensemble.
Satu hal yang sering terlewatkan oleh praktisi baru adalah biaya “technical debt”. Model ML yang kompleks memerlukan pemeliharaan rutin, pembaruan data, serta penyesuaian hyper‑parameter. Di sisi lain, model statistik tradisional cenderung stabil selama periode ekonomi yang relatif konstan, sehingga beban operasionalnya lebih ringan. Dari pengalaman saya, menggabungkan keduanya dalam arsitektur hybrid—misalnya, menggunakan regresi logistik sebagai baseline dan menumpangkan model Gradient Boosting untuk segmen nasabah berisiko tinggi—sering menghasilkan keseimbangan antara akurasi dan kontrol.
Terakhir, ingatlah bahwa pilihan metode harus selalu disesuaikan dengan tujuan bisnis dan kondisi data yang ada. Tidak ada “satu ukuran cocok untuk semua”. Seperti yang saya temui di beberapa fintech, keputusan yang tepat adalah yang dapat dijelaskan kepada regulator, dipahami oleh tim produk, dan menghasilkan nilai tambah yang terukur bagi nasabah. Untuk terus mengikuti praktik terbaik, saya rutin membaca insight di Strategy News, yang menyediakan rangkaian artikel tentang evolusi ML di sektor keuangan.
Tips Praktis untuk Memulai Penerapan Machine Learning di Keuangan
Dari pengalaman saya ketika pertama kali menggelar proyek fraud‑detection di sebuah fintech, hal terpenting yang harus dipastikan adalah kebersihan data. Saya memulai dengan audit data harian selama dua minggu, menghapus duplikat, menstandardisasi format tanggal, dan menandai outlier yang jelas. Tanpa langkah ini, model gradient‑boosting yang saya pilih malah memberi false‑positive tinggi, menambah beban tim compliance.
Berikut tiga langkah yang dapat Anda terapkan langsung:
- Identifikasi “quick win”: Pilih use‑case yang data sudah terpusat (misalnya, churn prediction berbasis transaksi kartu). Gunakan algoritma decision tree atau logistic regression; keduanya mudah dipantau dan tidak memerlukan infrastruktur MLOps yang rumit.
- Bangun pipeline data otomatis: Manfaatkan tools seperti Apache Airflow atau Prefect untuk mengekstrak, transform, dan load (ETL) setiap malam. Pastikan ada checkpoint untuk memvalidasi integritas (row count, missing ratio) sebelum data masuk ke training.
- Uji model secara A/B di lingkungan produksi: Saya pernah menjalankan model scoring kredit secara paralel dengan model legacy selama 30 hari. Hasilnya, akurasi ROC‑AUC naik 3‑4 poin, namun biaya operasional naik 12 %. Dengan metrik ini, manajemen dapat menilai trade‑off secara objektif.
Jangan lupakan technical debt. Setiap kali Anda menambahkan fitur baru, catat versi data schema dan hyper‑parameter yang dipakai. Dokumentasi ini menyelamatkan tim saya ketika regulator meminta audit model; tanpa jejak perubahan, proses review memakan minggu, bukan hari.
Pertanyaan yang Sering Ditanyakan tentang Mengenal Machine Learning dan Penerapannya di Sektor Keuangan
Apa itu Machine Learning dalam konteks keuangan?
Machine Learning adalah teknik komputasi yang memungkinkan komputer belajar pola dari data historis tanpa diprogram secara eksplisit. Di sektor keuangan, ia dipakai untuk memprediksi risiko kredit, mendeteksi penipuan, atau menyesuaikan penawaran produk secara real‑time.
Bagaimana cara memulai proyek Machine Learning di bank atau fintech?
Mulailah dengan definisi masalah bisnis yang jelas, kumpulkan data relevan, lalu lakukan eksplorasi dan pembersihan data. Pilih model yang sederhana (misalnya logistic regression) untuk baseline, kemudian iterasi dengan algoritma yang lebih kompleks bila diperlukan. Pastikan pipeline produksi sudah otomatis sehingga model dapat di‑update secara berkala.
Apakah Machine Learning lebih baik daripada metode statistik tradisional?
Tidak selalu. Model statistik seperti ARIMA atau regresi linear tetap unggul untuk data yang stabil dan interpretasi regulatif. Machine Learning mengungguli ketika terdapat fitur non‑linier, volume data besar, atau kebutuhan real‑time. Kombinasi keduanya—misalnya, menggunakan regresi logistik sebagai baseline dan menumpangkan model XGBoost untuk segmen berisiko tinggi—sering memberi hasil paling seimbang.
Bagaimana cara mengatasi tantangan regulasi saat menggunakan Machine Learning?
Regulator biasanya menuntut transparansi model. Gunakan teknik explainable AI (misalnya SHAP atau LIME) untuk menjelaskan kontribusi tiap fitur pada keputusan. Selain itu, simpan log versi model, data training, dan metrik performa; ini memudahkan audit dan meminimalkan risiko penolakan.
Apakah investasi infrastruktur MLOps wajib untuk semua institusi keuangan?
Untuk proyek skala kecil atau proof‑of‑concept, pipeline manual dengan script Python dan scheduler sederhana sudah cukup. Namun, bila model dipakai secara produksi 24/7—seperti sistem deteksi fraud real‑time—MLOps (CI/CD, monitoring, auto‑scaling) menjadi penting untuk menjaga keandalan dan mengurangi downtime.
Berapa lama biasanya sebuah model Machine Learning dapat di‑deploy di sektor keuangan?
Waktu deploy sangat tergantung kompleksitas data dan regulasi. Proyek “quick win” dengan data terstruktur bisa selesai dalam 4‑6 minggu, sementara solusi end‑to‑end (data lake, model ensemble, monitoring) mungkin memakan 3‑6 bulan.
Apa risiko utama yang harus diwaspadai saat mengimplementasikan Machine Learning?
Risiko paling umum meliputi bias data (misalnya, data historis yang diskriminatif), overfitting pada data training, serta ketergantungan pada fitur yang dapat berubah drastis (concept drift). Mitigasinya: lakukan audit bias, gunakan cross‑validation, dan implementasikan monitoring drift yang memberi alarm saat performa model menurun.
Kesimpulan
Setelah menggali seluk‑beluk mengenal Machine Learning dan penerapannya di sektor keuangan, saya menyadari bahwa keberhasilan bukan soal teknologi paling canggih, melainkan tentang menyeimbangkan kecepatan inovasi dengan kontrol risiko. Contoh nyata yang saya alami—menggabungkan model regresi logistik dengan Gradient Boosting untuk menilai kelayakan pinjaman—menunjukkan bahwa hybrid approach memberi akurasi tinggi sekaligus tetap dapat dijelaskan kepada regulator.
Jika Anda ingin memulai, pilih dulu satu kasus bisnis yang memiliki data bersih dan nilai bisnis yang terukur. Bangun pipeline otomatis, uji model secara terbatas, dan dokumentasikan tiap perubahan. Dengan langkah‑langkah kecil yang terukur, Anda tidak hanya mengurangi technical debt, tetapi juga menyiapkan fondasi untuk skala yang lebih besar di masa depan.
Jangan tunggu sampai kompetitor meluncurkan fitur AI yang lebih pintar. Mulailah sekarang, catat pelajaran yang Anda dapat, dan manfaatkan komunitas praktisi—seperti yang sering saya dapatkan di strategy news—untuk terus mengasah strategi Machine Learning Anda. Karena pada akhirnya, keunggulan kompetitif di industri keuangan datang dari keputusan yang didukung data, bukan sekadar intuisi.
- Penulis: admin